DeepSeek V4.1-Flash 拆解:8B prefill 打贏旗艦、KV cache 縮到 1/4
2026-09-28 · AI 實戰 · Eric Cheung
發佈:2026年9月10日,V4.1-Flash 直接取代 V4-Pro
DeepSeek 喺 2026年9月10日發佈 DeepSeek-V4.1-Flash,官方定位係「新架構家族裡面最細嘅一隻」,同時開源權重同出技術報告。最實用嘅一句係官方自己講:多個第三方測試顯示 V4.1-Flash 喺性能、成本、速度同總運行時間都超前旗艦 V4-Pro,所以佢開始淘汰 V4-Pro。
呢篇唔做轉載。對落地真正有影響嘅係四件事:① 佢點樣用 8B active 參數做 prefill;② KV cache 縮到四分之一,對 agent 成本結構有咩實際改變;③ 舊 model 名同 V4-Pro 流量會點被路由;④ 官方 benchmark 同第三方實測邊幾行要打折扣。價錢、規格同路由政策嚟自 DeepSeek 官方 news 頁同官方定價頁(2026年9月28日查),第三方資料會另外標明。
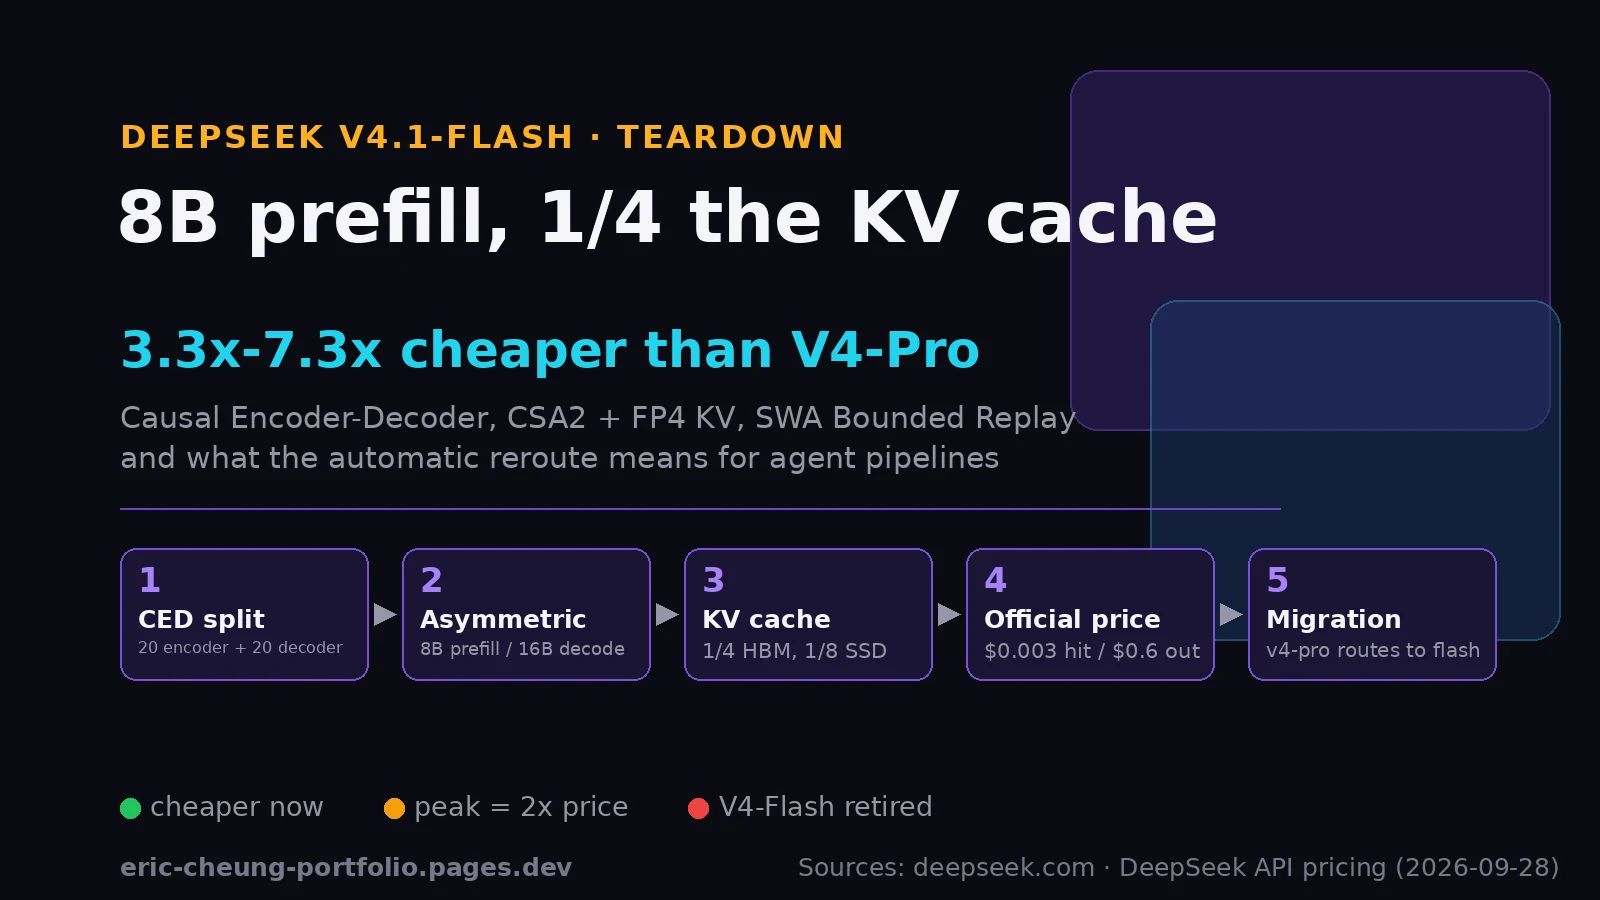
快速結論(TL;DR)
- DeepSeek 2026年9月10日發佈 V4.1-Flash:552B MoE 骨幹、支援 1M context、384K 最大輸出,仲由實驗版升級到正式支援原生圖像輸入(V4-Pro 唔支援 vision)。
- 關鍵架構係 Causal Encoder-Decoder:40 層拆成 20 層 encoder + 20 層 decoder,讀入(prefill)只啟用 8B 參數,生成(decode)16B;舊 V4-Flash 係兩邊都 13B —— 呢個不對稱設計正正針對 agent 迴圈「輸入遠多過輸出」嘅成本結構。
- KV cache 縮到 V4-Flash 嘅 1/4(global、890 bytes/token),放 SSD/host 嘅 persistent 部分係 1/8;靠 CSA2 跨層共用、FP4 低精度 KV 同 SWA Bounded Replay 三招夾埋。
- 官方定價(USD/百萬 tokens,離峰):cache hit $0.003、cache miss $0.15、output $0.6;同一時間 V4-Pro 係 $0.022/$0.66/$1.98 —— 即係 hit 平 7.3 倍、miss 平 4.4 倍、output 平 3.3 倍,並發上限仲高 5 倍(2500 對 500)。
- 遷移要留意:V4-Flash 系列已退役,2026年9月14日起 `deepseek-v4-pro` 嘅請求會直接路由去 V4.1-Flash 並按 Flash 價收費,直到 V4.1-Pro 推出;但 Automation-Bench 只有 54.8 分,複雜 workflow 仍要留人手覆核。
架構:CED 令讀入只動 8B、生成 16B
大模型推理分兩步:prefill(讀你嗰堆輸入、建立 KV cache)同 decode(逐個 token 生成輸出)。其他 MoE 模型兩步啟用相同參數量,V4.1-Flash 就將成個骨幹拆成一個 20 層 causal encoder 加一個 20 層 decoder,decoder 嘅 KV cache 直接由 encoder 輸出投影出嚟 —— 所以 prefill 只需要跑 encoder。
- 不對稱啟用:prefill 8B active/token、decode 16B active/token;舊 V4-Flash 係 13B/13B —— 生成比讀入難,所以算力優先撥去 decode
- 規模:552B backbone MoE + 196B Engram 參數;40 層=20 層 causal encoder + 20 層 decoder;第一、二層只用 sliding-window attention
- 多模態:原生圖像輸入(視覺 encoder 由零訓練)+ 文字輸出;正式版支援 vision,V4-Pro 官方標明唔支援
- 上限:context 1M tokens、最大輸出 384K、思考模式預設開啟(可調 reasoning effort 1–100);支援 JSON output、tool calls、Responses API、Anthropic API 同 FIM(非思考模式)
對 agent 嘅意義好直接:一個 agent 迴圈每一步都會重發大部分相同 context,所以**讀入 token 通常遠多過輸出 token**。以前每步都要用 13B active 讀一次;而家用 8B 讀、16B 寫,成本重心就跟實際 token 分佈對齊。官方預訓練用咗 45T tokens 多模態語料,sparse attention 先喺 64K 序列長度訓練,到 34T tokens 時先擴到 1M context。
KV cache:HBM 減到 1/4、SSD 減到 1/8
長 context 嘅真正瓶頸往往唔係算力,而係 KV cache 佔幾多 HBM 同要唔要落 SSD。DeepSeek 官方數字:V4.1-Flash 嘅 KV cache 只需要上一代嘅 1/4 HBM 同 1/8 SSD 儲存;global KV 做到 890 bytes/token,同 V1 世代比差 437 倍。
- Compressed Sparse Attention 2(CSA2):每一層靜態分配三種模式之一 —— Full(產生 global KV 同做 indexing)、Reindex(重用前一層 global KV,但用自己嘅 indexer Q 重新揀 Top-K)、Reuse(連 Top-K 索引一齊重用)。跨層共用 main KV 同 indexer K,直接慳重複儲存;decoder 再加 hierarchical sparse indexer,令深層 indexing 成本唔再隨 context 長度線性上升
- FP4 KV 快取:main KV 用 E2M1 格式儲存,每 16 條 channel 配一個 E4M3 scale —— 官方話訓練時已經用 FP4,性能跌幅有限
- SWA Bounded Replay:deployment 層嘅招。舊做法要精確重建 sliding-window KV 就要重播 L×n_win 個 token;新做法只重播最近 n_win 個 token 做近似重建,因此唔需要將 SWA KV 持久化落 SSD,官方話性能影響可以忽略
呢三招合埋有兩重意義:一是記憶體帳單細咗,二是 cache hit 率 —— cache 細就放得落更多 context,prefix 命中嘅機會高,命中就直接跳過重算 attention,time-to-first-token 同每 GPU 吞吐一齊改善。官方自己都講「cache-hit 費用往往佔 agent 成本一大截」,所以壓縮 cache 係壓成本最直接嘅一步。
官方定價:比 V4-Pro 便宜 3.3 至 7.3 倍
- deepseek-flash(=DeepSeek-V4.1-Flash):cache hit 離峰 $0.003 /尖峰 $0.006;cache miss $0.15 / $0.3;output $0.6 / $1.2(USD/百萬 tokens)
- deepseek-v4-pro(=V4-Pro-0813):cache hit $0.022 / $0.044;cache miss $0.66 / $1.32;output $1.98 / $3.96
- 換算差距:cache hit 平 7.3 倍、cache miss 平 4.4 倍、output 平 3.3 倍 —— 即係越依賴 cache 命中嘅 agent 場景,省得越多
- 並發上限:Flash 2500、V4-Pro 500(高 5 倍),對高頻呼叫嘅生產線有實際影響
- 峰谷時段:尖峰係 UTC 01:00–04:00 同 06:00–10:00(星期一至五,中國公眾假期除外),其餘時段(含週末同中國假期)全部係離峰價,即係半價
一個實務提醒:離峰係一半價,唔係「平少少」。批量 job、夜跑 eval、文件摘要呢類可以排程嘅工作,排去離峰即係直接砍半;但實時 agent 就冇得揀,所以要靠 cache 命中率同 output 長度控制去省。價錢同 model 名單以官方定價頁為準,DeepSeek 明言有權改價。
遷移:舊 model 名會點、V4-Pro 流量去邊
- 新代碼直接用 model 名 `deepseek-flash`;舊名 `deepseek-v4-flash` 同 `deepseek-v4-flash-vision-exp` 仍然收得到,但對應模型已退役,請求由 V4.1-Flash 服務、按 Flash 價收費
- 原本只支援實驗版 vision 嘅路徑,而家正式版就支援原生圖像輸入 —— 之前用 Vision-Exp 做嘅截圖分析、圖表解讀可以直接搬過去
- 2026年9月14日 04:00 UTC 起,所有 `deepseek-v4-pro` 請求會路由到 V4.1-Flash 並按 V4.1-Flash 價收費,直到 V4.1-Pro 推出;換言之「Pro 名字、Flash 行為、Flash 價錢」
- 如果你嘅 prompt 依賴 V4-Pro 獨有行為(例如某些長鏈推理習慣),要喺正式切換前自己 A/B 一次 —— 路由係自動嘅,唔會問你
- 生態方面:官方夥伴 WorkBuddy(含 CodeBuddy)同 OpenCode 已全面支援;release 本身冇附 Jinja chat template,需要自己砌 prompt 嘅話官方另出 `deepseek-recipe`(Rust 核心 + Python bindings)做 Conversation 編碼/解碼
官方亦講得好白:如果你係認真要自架大規模部署,「2,000 張 GPU 加一個儲存叢集」先值得坐低傾。細團隊同個人用 API 起步仍然係合理選擇,順帶一句 —— 呢個「KV cache 壓縮」方向唔止 DeepSeek 做,想睇本地/雲端之間點取捨可以參考 本地 vs 雲端 AI 分析。
Benchmark 點讀:Automation-Bench 54.8 即係仲有一半會失敗
- 贏 V4-Pro,但用三分之一參數:第三方整理指 V4.1-Flash 喺 coding 同 agentic benchmark 全面超前 V4-Pro;進步最大嘅係長時程 agentic 任務(雙位數),單次 CLI 任務嘅進步較細
- Automation-Bench 54.8:即係複雜 workflow 仍然有近一半會失敗 —— 直接結論係 agent pipeline 要留人手覆核,唔好當佢可以無人值守
- 視覺推理:第三方指圖表解讀同圖像邏輯推理明顯改善,餵截圖、dashboard、UI mock-up 嘅場景最受惠(V4-Pro 唔支援 vision,所以呢類任務以前冇 Pro 路可揀)
- 第三方基準表(例:Xiaomi 自測表列 DeepSWE v1.1):V4.1-Flash 74.2,同 Claude Opus 5 嘅 74.0 同級 —— 但廠商自測表嘅對手分數係自己跑,唔等於對手官方數字,只可以當方向性參考
一句總結 benchmark:V4.1-Flash 嘅定位係「接近旗艦嘅 agent 能力,但用少三分二參數、平一大截」,唔係「全面最強」。真正要決策嘅位唔係榜首,而係你嗰條 pipeline 最貴嘅部分係 prefill、cache hit 定 output —— 三樣嘅省錢幅度唔同,揀之前最好用自己嘅 workload 跑一次成本對比。
對實戰嘅意義
呢次發佈最值得學嘅唔係分數,而係成本結構被重新分配:輸入讀取唔再同輸出生成一樣貴,KV cache 由「買幾多 HBM」變成「cache 命中率有幾高」。
- Agent 開發者:成本重心由 output 移向 prefill/cache,穩定嘅 system prompt 同 prefix 會直接反映落帳單 —— 減少每次重寫 prompt 開頭變成真正嘅省錢手段
- 已用 V4 系列嘅團隊:因為 V4-Pro 流量自動路由,你唔升級都會「被升級」;趁機會量度一次延遲、成功率同成本,先至知係賺定蝕
- 新項目:1M context + 384K 輸出 + 原生視覺 + 2,500 並發,呢組合喺一年前係旗艦級配置,而家係中價位 —— 可以直接 build 長文件、長對話同截圖理解類產品
- 要留意嘅風險:model 名同價錢都可以一夜之間改路由,任何依賴單一 provider 嘅 pipeline 都應該有 fallback;成本控制亦要覆蓋 cache 命中率而唔止 token 數
想睇上一個世代(V4-Flash 0731 對 V4-Pro)嘅定價同 benchmark 拆解,可以參考 DeepSeek V4 Flash vs V4 Pro 對比;如果關心嘅係企業層面點管 AI 成本,企業 AI 成本管理指南 有整套框架。