AI 敏捷估算:BA/PM 用 AI 預測 Story Point 同 Velocity 嘅 5 步工作流
2026-08-21 · BA × AI 實戰 · Eric Cheung
點解 Sprint 估算成日「估錯」
每個做過敏捷嘅 BA/PM 都識呢個場景:sprint planning 嗰日,成 team 人對住一張 backlog,每張 story 都用「感覺」估點數。有人慣性畀 3 點,有人慣性畀 8 點;product owner 問「點解呢張係 5 唔係 3?」——冇人答得出。結果 sprint 行到一半,先發現高估咗或者低估咗,commitment 又一次甩轆。
估算唔準唔係因為團隊唔叻,而係傳統估算方法有兩個結構性問題:第一,靠記憶——冇人記得三個月前同類 story 實際用咗幾多點;第二,靠感覺——人嘅判斷好易受 anchoring bias(第一個講出口嘅數字會拉郁所有人)同 recency bias(最近做過類似嘢就自然估細啲)影響。AI 改變咗呢件事:大型語言模型可以讀晒成個 backlog 嘅歷史、用統一標準將大 story 拆成細 task 逐個估、再用過去 6-8 個 sprint 嘅數據計出 Velocity 趨勢。但注意——AI 嘅估算唔係取代團隊判斷,佢係一個「有數據根據嘅參考基準」,等你哋嘅 Planning Poker 由「憑感覺」變成「對答案」。
快速結論(TL;DR)
- 估算唔準嘅根源係「靠記憶 + 靠感覺」——anchoring bias 同 recency bias 令團隊嘅點數永遠有系統性偏差
- AI 嘅角色係「有數據根據嘅參考基準」,唔係取代團隊判斷——Planning Poker 變成對答案,唔係跟 AI
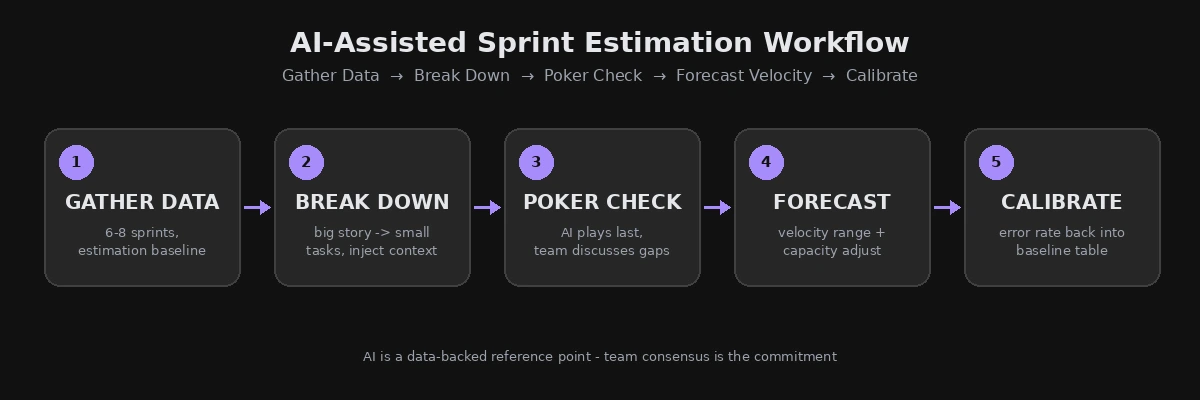
- 5 步工作流:收集歷史數據 → 拆解獨立估算 → Poker 對答案 → 預測 Velocity → 校準回顧
- Story Point 只係相對大小,唔預測 Velocity 同 Capacity,commitment 一樣會甩轆
- 每 sprint 尾做校準回顧,將估算誤差寫入基準表——你建立嘅係一個會自我改進嘅估算系統
5 步工作流:由歷史數據到可靠估算
Step 1 — 收集同整理歷史數據
歷史數據係成個工作流嘅燃料。將過去 6-8 個 sprint 嘅資料整理出嚟:每張已完成 story 嘅標題同描述、原本估咗幾多點、實際完成用咗幾多點(如果有 track)、以及佢屬於邊個 epic/功能範疇。公司用 Jira 可以直接 export;如果從來冇正式 track,用 git commit 歷史、PR 或者會議紀錄大概重建。呢步嘅輸出係一張「估算基準表」:Story 類型 × 歷史平均點數。之後 AI 嘅所有估算都會 base on 呢張表,唔係憑空作——呢點係成個工作流同「直接掟 backlog 畀 ChatGPT」嘅分別。
- 數據來源:Jira export、試算表、或者 git 歷史+PR 重建
- 最少要 20-30 張已完成 story 先有統計意義,少過就擴大時間範圍
- 每張 story 記錄:描述、估點、實際點、類型、所屬 epic
- 輸出:一張「估算基準表」(Story 類型 × 歷史平均點數)
Step 2 — 用 AI 拆解需求再做獨立估算
拆解係準確估算嘅關鍵:8 點以上嘅大 story 通常因為「未拆清楚」而估唔準。將今個 sprint 要估算嘅 backlog 交畀 AI,叫佢分開做兩件事:第一,將每張大 story 拆成細 task(一個 task 係一個可以獨立完成嘅工作單元);第二,逐個 task 按 Step 1 嘅基準表估點數,最後加總。重點係「分開做」:拆解嗰陣你要加入 AI 唔知嘅 context(例如「呢個 task 要同 legacy system 對接」、「呢個改動要過合規審批」),估算嗰陣先至交返畀 AI 對基準。
我哋嘅團隊用 Scrum。以下係過去 8 個 sprint 嘅歷史數據(story 描述、估算點數、實際點數、類型),另外附上今個 sprint 要估算嘅 backlog。請你:
1. 先分析歷史數據:每種類型 story 嘅「估算 vs 實際」平均誤差
2. 將每張要估算嘅 story 拆成細 task,列出每刀嘅拆解理由
3. 逐個 task 按歷史基準估算點數,並註明參考咗邊張歷史 story
4. 輸出每張 story 嘅建議點數 + 信心度(高/中/低)

--- 貼上歷史數據 ---
--- 貼上 backlog ---
Step 3 — Planning Poker 對答案:AI 做「虛擬參考點」
傳統 planning poker 係成 team 各自出牌再討論。而家嘅做法:將 Step 2 嘅 AI 估算作為「第 N+1 位虛擬參與者」加入 poker session——同事出完牌之後,先至公開 AI 嘅建議值。如果 AI 同團隊共識差好遠(例如團隊話 5、AI 話 13),通常代表有一方掌握咗對方冇嘅資訊:或者團隊知道某個技術風險,或者 AI 見到歷史上有類似 story 實際用咗 13 點。呢個差異就係討論嘅燃料——目的唔係要大家跟 AI,而係逼大家講出估算背後嘅假設。關鍵規則:AI 一定要後出牌,否則佢嘅數字會變成 anchoring,成個討論即刻死咗。
- AI 後出牌:同事先各自出牌,公開之後先show AI 建議值
- 差異超過 2 點嘅 story 一定要討論,唔好為咗快而妥協
- 將討論出嚟嘅假設(技術風險、歷史先例)即場寫低
- 共識點數先係正式 commitment,AI 數字只係參考
Step 4 — 用 AI 預測 Velocity 同 Capacity
Story Point 估算只係一半,另一半係:個 sprint 到底裝得落幾多點?將過去 6-8 個 sprint 嘅 velocity(實際完成點數)交畀 AI,叫佢計移動平均同標準差,再按下個 sprint 嘅 capacity 調整——有冇人放假、有冇人調走、有冇新人要 onboarding。輸出係一個 commitment 範圍(例如「24-30 點」)而唔係一個死數。呢個範圍就係你喺 sprint planning 同 management 傾 commitment 嘅根據:低標係穩陣承諾,高標係 stretch goal。
- 用 6-8 個 sprint 嘅移動平均,唔好淨係用上個 sprint 嘅數字
- 調整 capacity:假期、缺席、新人 onboarding、跨專案支援
- 叫 AI 輸出「範圍 + 信心度」,唔好輸出一個假精準嘅死數
- 低標=穩陣 commitment,高標=stretch goal,兩者都擺上枱
Step 5 — 校準回顧:將估算誤差變成團隊資產
Sprint 完咗之後,將實際完成點數同估算對返:邊類 story 成日低估?邊類成日高估?誤差有冇 trend?將呢啲數據寫返入 Step 1 嘅基準表,AI 下次估算就會自動調整。呢個就係「估算系統」同「一次性估算」嘅分別:你建立嘅唔係一個數字,而係一個會自我改進嘅機制。做三至四個 sprint 之後,你會見到誤差率收窄——因為基準表累積咗你哋團隊真實嘅工作模式,而唔係業界平均。
- 每 sprint 尾用 15 分鐘做校準,唔好等到 retrospective 先一次過
- 記錄誤差率:估 5 實際 8 = +60%,估 8 實際 5 = -37%
- 按 story 類型歸納誤差,搵出邊類 consistently 估錯
- 基準表每月更新一次,確保 AI 學到最新嘅團隊節奏
3 個常見陷阱
- 陷阱一:直接叫 AI 俾個數就當答案。冇歷史數據、冇拆解、冇 context,AI 嘅估算同擲骰仔冇分別——佢只會俾你一個「聽落好合理」嘅數字。一定要行完 Step 1-2 先有得估。
- 陷阱二:喺 Planning Poker 一開始就公開 AI 數字。Anchoring bias 會令成 team 自動向 AI 靠攏,討論即刻死咗。AI 一定要後出牌,做「對答案」嘅參考,唔係做「標準答案」。
- 陷阱三:淨係估 Story Point,唔理 Velocity 同 Capacity。Story point 只係相對大小,唔等於團隊實際做得到嘅量。唔預測 velocity、唔計 capacity,commitment 一樣會甩轆——兩個數字要一齊用。
總結
估算唔準嘅根源係「靠記憶 + 靠感覺」;AI 將佢變成「靠數據 + 對答案」。記住呢個 5 步循環:收集歷史數據 → 拆解獨立估算 → Poker 對答案 → 預測 Velocity → 校準回顧。你嘅角色由「估點數嘅人」升級做「設計估算系統嘅人」——呢個先係 BA/PM 嘅價值。下次 sprint planning,唔好再憑感覺出牌:用歷史數據打好個底、用 AI 做參考點、用討論做把關、用回顧做校準。三、四個 sprint 之後,你會發現團隊嘅估算唔再係「求其」,而係一個愈用愈準嘅系統。